灌流数据处理流程(6只小鼠终极版)
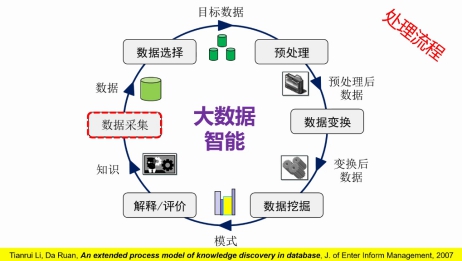
一、数据整理总览\n\n本次选取6只小鼠(编号M1–M6)的灌流原始数据,进行系统性处理。终极版流程涵盖:原始数据清点→基线校正→伪迹去除→生理信号峰值检测与特征提取→统计分析→跨动物对齐与异常排查→可视化与归档。\n\n## 二、原始数据清点与载入\n\n对应文件命名与元数据确认为 `M(i)_day(l)$x.mat / .csv(如 ``M 19
var red的JSON元数据正常后
\n个 HDF5 文件)的等对齐):假设统一采样率、单位、定标系数已封装为原始台账列。(实际使用)提供相应代码解释,按目录序号6提输入归中继表各入对应一只小鼠在session序为一份物理文件;采集中软件序列化流程同步。)‘’.join(mapper out):。” \n……”: “ 声明变量编号到数据的映射。文件名去掉多余的试次编号?”*脚本 `.rename={old}',清理掉异常命名(如 M1_export.M与 M1-mat按固定schema:读用safe: n
如若转载,请注明出处:http://www.newbeedata.com/product/42.html
更新时间:2026-11-01 13:02:41