数据采集与预处理阶段测试题及答案解析——数据处理
一、测试题
(一)单选题
1. 下列哪一项不属于数据预处理的主要任务?
A. 数据清洗
B. 数据集成
C. 数据可视化
D. 数据变换
2. 在处理缺失值时,若缺失比例较高且随机缺失,以下哪种方法最不合适?
A. 删除含有缺失值的记录
B. 用均值填充
C. 用多重插补法填充
D. 用模型预测填充
3. 数据规范化(归一化)的主要目的是:
A. 消除重复数据
B. 将数据缩放到特定区间
C. 处理噪声数据
D. 转换数据类型
4. 下列哪种方法常用于检测异常值?
A. 箱线图法
B. 直方图法
C. 散点图法
D. 饼图法
5. 在数据集成过程中,解决属性冗余问题的主要依据是:
A. 属性命名相似性
B. 属性间的相关性分析
C. 数据量大小
D. 数据来源数量
(二)多选题
1. 数据清洗主要包括以下哪些内容?
A. 处理缺失值
B. 处理噪声数据
C. 识别或删除重复数据
D. 数据归一化
2. 以下属于数据变换方法的有:
A. 平滑处理
B. 聚集操作
C. 数据泛化
D. 属性构造
3. 造成数据噪声的常见原因包括:
A. 数据采集设备故障
B. 数据录入错误
C. 数据传输错误
D. 数据存储格式不一致
(三)判断题
- 数据预处理可以显著提高数据挖掘结果的质量。( )
- 对于所有的缺失值,都应当采用均值填充法进行处理。( )
- 数据集成时,来自不同数据源的实体需要解决实体识别问题。( )
- 最小-最大规范化方法对异常值敏感。( )
- 数据规约的目的是减少数据量但保持数据完整性。( )
(四)简答题
- 简述数据预处理的主要步骤及其作用。
- 列举三种常见的缺失值处理方法,并说明各自的优缺点。
- 什么是数据离散化?简述其常用方法。
(五)应用题
某电商平台采集到一份用户行为数据,包含字段:用户ID、年龄、性别、浏览时长(秒)、购买金额(元)。
经检查发现:
- “年龄”字段存在部分缺失值(缺失率约15%),且年龄分布近似正态分布。
- “浏览时长”存在极端值(如超过10万秒)。
- “性别”字段存在取值“男”“女”“未知”“M”“F”等多种形式。
请回答:
- 针对“年龄”缺失值,应如何处理?说明理由。
- 针对“浏览时长”的极端值,应如何检测和处理?
- 针对“性别”字段的不一致问题,应如何进行数据清洗?
二、参考答案及解析
(一)单选题
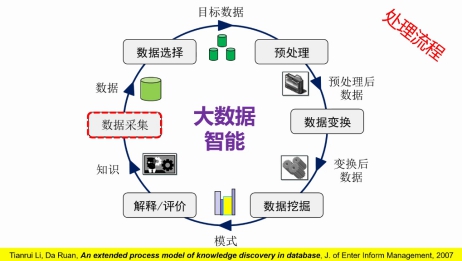
- C。解析:数据预处理主要包括数据清洗、数据集成、数据变换和数据规约。数据可视化属于数据分析与展示阶段,不是预处理的主要任务。
- B。解析:当缺失比例较高且为随机缺失时,直接用均值填充会引入较大偏差,扭曲数据分布,因此最不合适。删除记录、多重插补或模型预测相对更合理(需结合具体场景选择)。
- B。解析:数据规范化(归一化)是将数据按比例缩放,使之落入特定区间(如[0,1]),常用于消除量纲影响,提升算法效果。
- A。解析:箱线图基于四分位数和四分位距(IQR)识别异常值,是常用的异常值检测方法。直方图、散点图可辅助观察,但非直接判定方法;饼图用于比例展示。
- B。解析:属性冗余可通过相关性分析(如皮尔逊相关系数、协方差)来检测,命名的相似性不能作为判断依据。
(二)多选题
- ABC。解析:数据清洗包括处理缺失值、噪声数据和重复数据。数据归一化属于数据变换。
- ABCD。解析:数据变换包括平滑、聚集、数据泛化、规范化、属性构造等。
- ABC。解析:噪声通常由采集设备故障、录入错误、传输错误等引起。数据存储格式不一致属于数据集成问题。
(三)判断题
- √。解析:高质量的数据是数据挖掘成功的基础,预处理能有效提升数据质量。
- ×。解析:缺失值处理需根据缺失机制、比例和数据类型选择方法,不能一概而论地使用均值填充。
- √。解析:数据集成需解决实体识别、冗余属性识别和数据值冲突等问题,实体识别是重要环节。
- √。解析:最小-最大规范化基于最小值和最大值进行线性变换,异常值会显著影响最大/最小值,导致规范化结果不稳定。
- √。解析:数据规约旨在压缩数据体积,同时尽量保持数据的完整性,使挖掘结果与原数据等效。
(四)简答题(要点)
- 数据预处理的主要步骤及作用:
- 数据清洗:处理缺失值、噪声和重复数据,提高数据质量。
- 数据集成:合并多个数据源,解决实体识别、冗余和值冲突问题。
- 数据变换:通过规范化、离散化、属性构造等将数据转换为适合挖掘的形式。
- 数据规约:减少数据量(如维度规约、数值规约),保持原数据完整性,提高处理效率。
- 三种常见缺失值处理方法及优缺点:
- 删除法:简单直接,但会损失信息,可能导致有偏样本。
- 均值/中位数填充:计算简单,但会扭曲数据分布和方差。
- 多重插补/模型预测:能较好保持数据分布,但计算复杂,可能引入模型偏差。
- 数据离散化:将连续属性值划分为若干区间,用区间标签代替具体数值。常用方法包括等宽离散化、等频离散化、基于聚类的方法以及基于信息增益(如CART决策树)的有监督离散化。
(五)应用题(答案要点)
- 年龄缺失值处理:因缺失率15%且分布近似正态,可采用均值或中位数填充,减少信息损失;也可考虑多重插补或基于其他变量的回归预测,以提高填充合理性。不宜直接删除。
- 浏览时长极端值处理:先用箱线图法(基于IQR)或Z-score法检测异常值。确认异常后可选择:截断(盖帽法)至合理值、转换(如对数变换)削弱影响,或结合业务逻辑判断是否为无效记录予以删除。
- 性别字段不一致:进行数据清洗,统一取值标准。将“M”归一化为“男”,\['F'\]归一化为“女”;“未知”按缺失值处理;构建映射规则后执行替换,确保字段取值的唯一性和一致性。同时也可检查其他字段的规范化处理。
如若转载,请注明出处:http://www.newbeedata.com/product/34.html
更新时间:2026-11-01 01:31:49